Personal side project · built on my own time, not company work
TrimScript - 녹취록을 고치면 영상이 잘리는 로컬 편집기
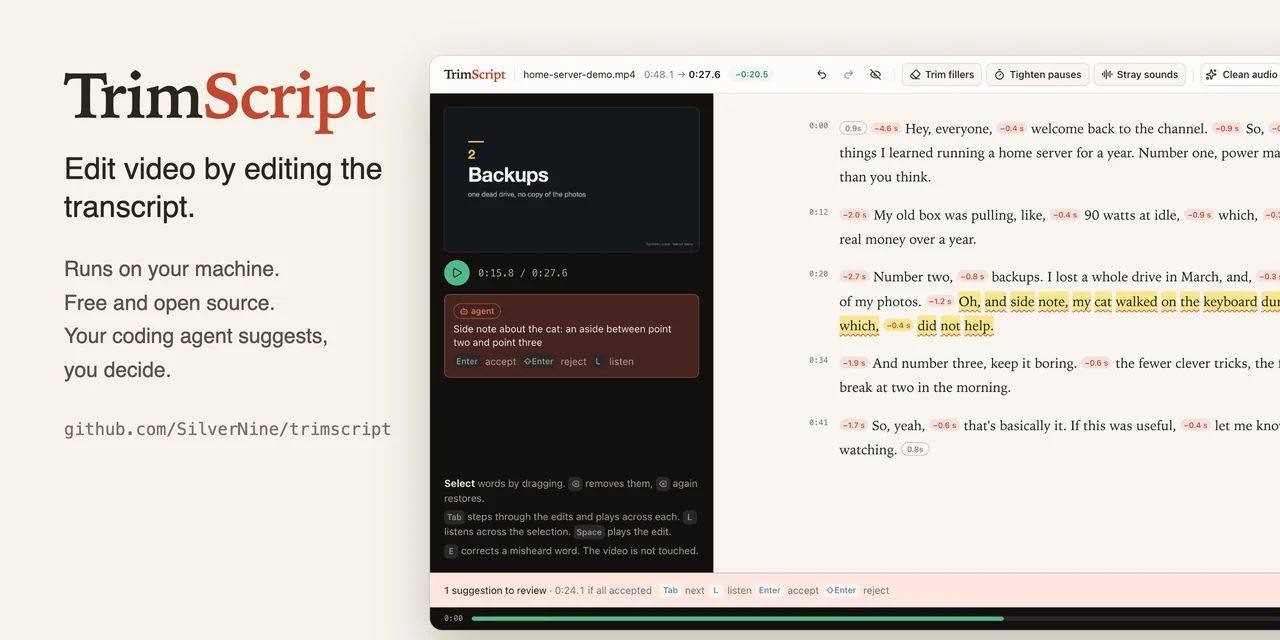
TrimScript는 말하는 영상(강연, 튜토리얼, 팟캐스트, 인터뷰)을 녹취록 문서처럼 편집하는 로컬 편집기입니다. 글자를 선택해 지우면 영상에서 그 구간이 빠집니다. 받아쓰기, 편집, 내보내기가 전부 내 컴퓨터에서 돌아가므로 계정도, 업로드도 없습니다. 원본 파일은 절대 수정하지 않고, 편집 내용은 영상 옆에 JSON 파일 하나로 남습니다.
GitHub: SilverNine/trimscript · PyPI: trimscript · MIT · 50초 데모 영상
uvx trimscript open my-video.mp4uv와 ffmpeg가 필요합니다. 2026-10-10에 v0.1.0을 공개한 초기 단계입니다.
데모
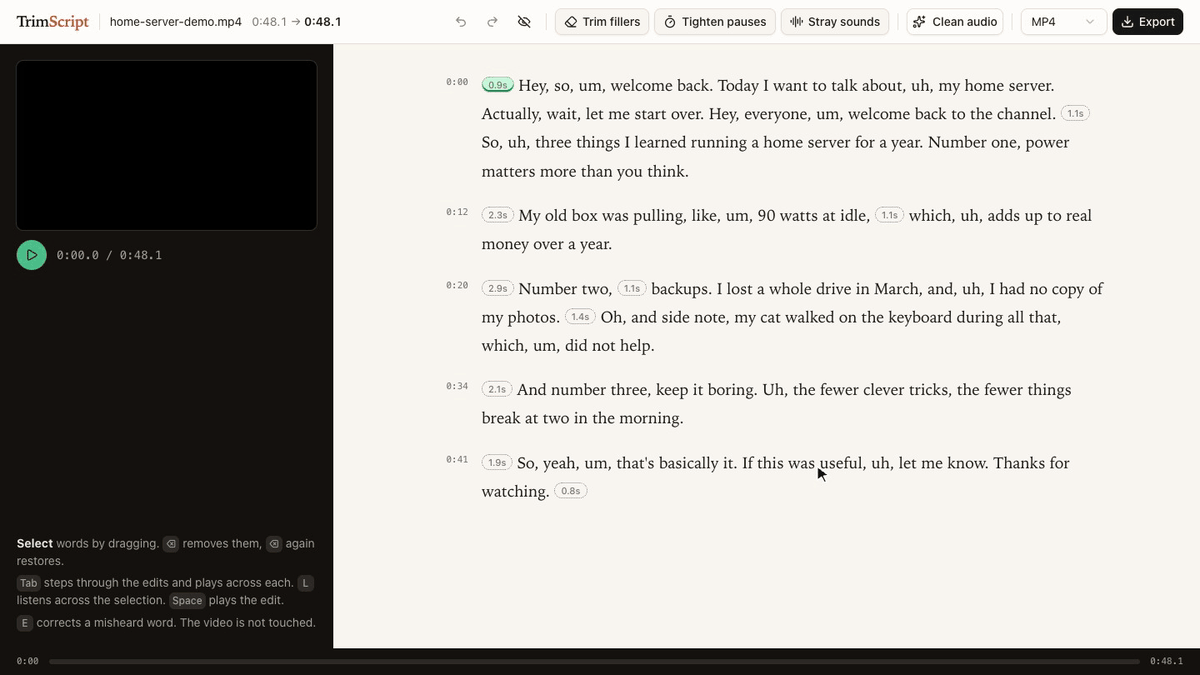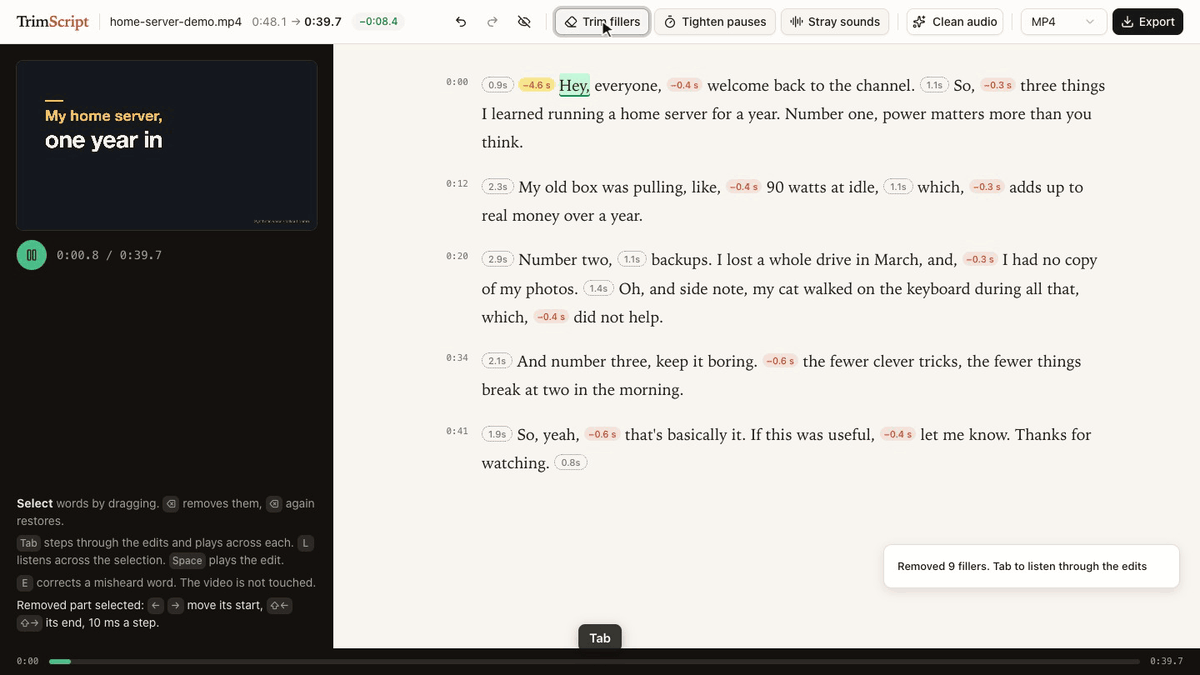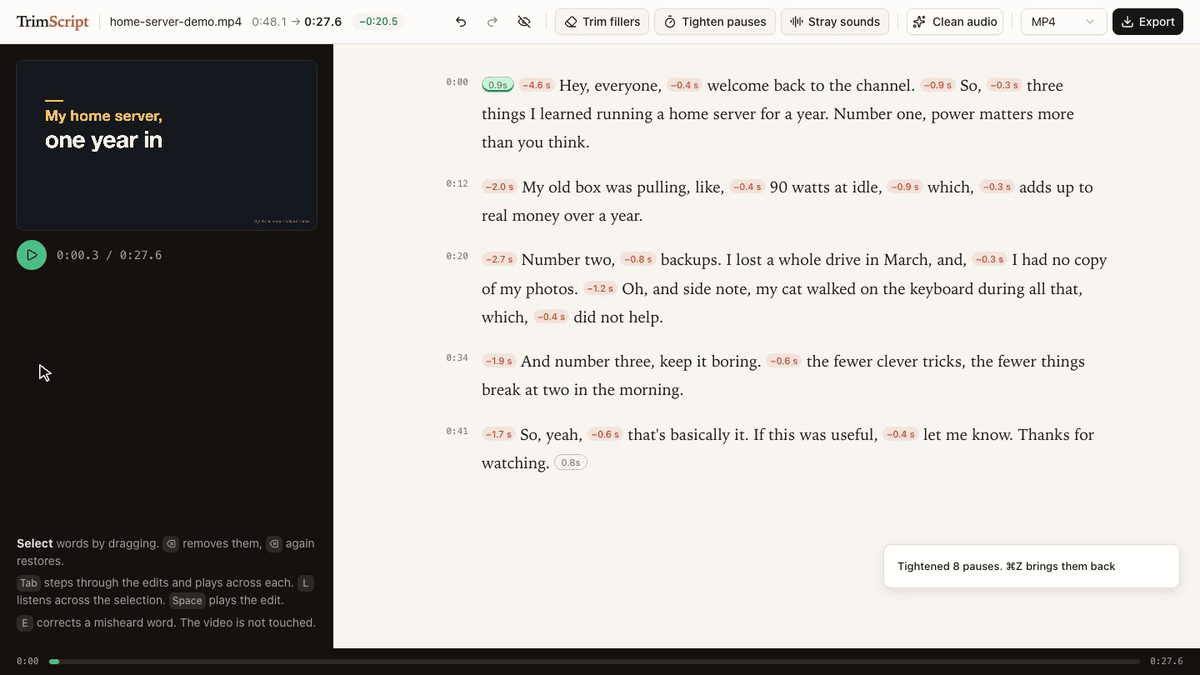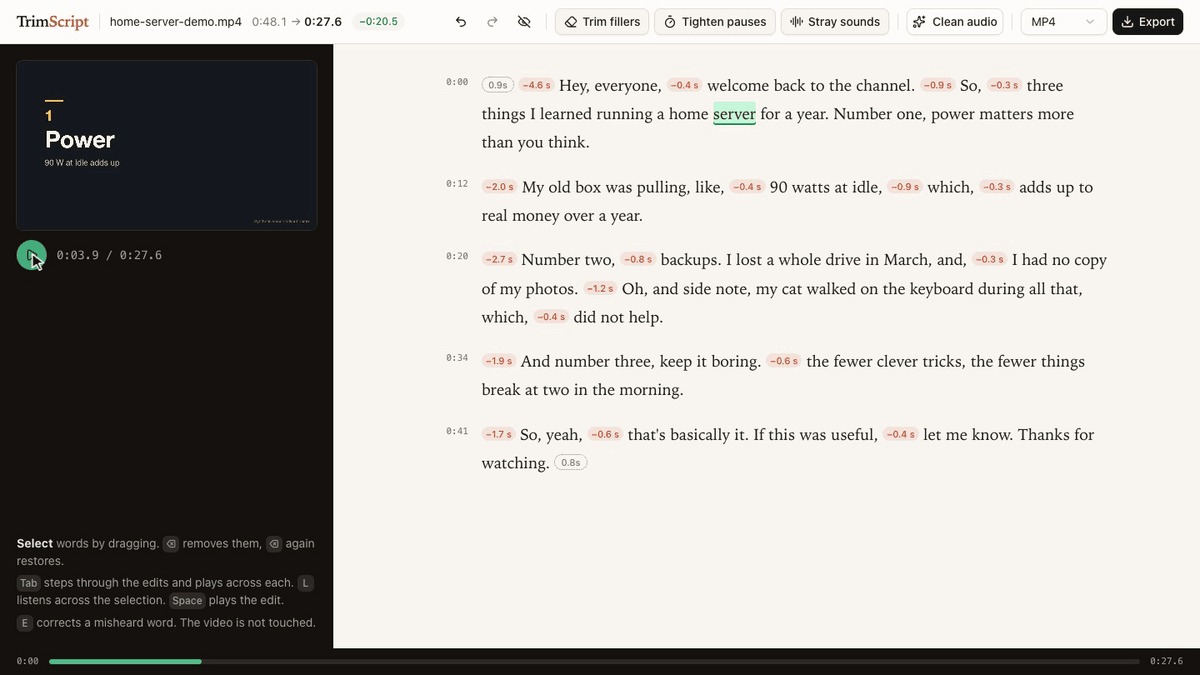
다시 시작한 인트로를 지우고, 군말을 한 번에 정리하고, Tab으로 편집점을 하나씩 들어 본 뒤 쉼을 줄입니다. 48.1초가 27.6초가 됩니다. 데모 속 강연은 데모용으로 쓴 대본이고 목소리는 Dia로 만든 합성음입니다.
주요 기능
- 로컬 받아쓰기: whisper.cpp(small.en)로 받아 적습니다. “um”, “uh”를 지우지 않고 그대로 적도록 프롬프트를 줍니다. 현재 영어만 지원
- 글자를 지우면 영상이 빠진다: 단어를 선택해 ⌫를 누르면 미리보기와 내보내기에서 그 구간이 빠집니다. 지운 자리는 아낀 초(예: -1.2 s)를 적은 작은 표시로 접히고, 다시 선택해 ⌫로 되살립니다
- 군말 정리·쉼 줄이기: Trim fillers로 모든 um·uh를 한 번에, Tighten pauses로 1초 넘는 쉼을 짧게. Tab으로 편집점마다 앞뒤 1.5초를 들어 보며 확인하고, ⌘Z로 전부 되돌립니다
- 빠진 소리 찾기: 녹취록에 단어가 없는데 목소리가 있는 자리(숨소리, 반 토막 단어, 인식기가 건너뛴 소리)로 바로 가서 들려 줍니다. 판단은 사람이 합니다
- 편집점 미세 조정: 방향키로 10 ms 단위로 옮기며 매번 이어 듣기
- 음성 정리: 잡음 제거, 레벨, 가벼운 압축, -14 LUFS 음량을 스위치 하나로. 녹음 길이는 바뀌지 않음
- 오인식 단어 수정: 미디어는 건드리지 않고 텍스트만 고치고, 자막에는 고친 텍스트가 들어갑니다
- 내보내기: MP4, WAV, SRT/VTT 자막, FCPXML(Final Cut Pro·DaVinci Resolve에서 편집점을 그대로 이어 편집)
코딩 에이전트와 같이 쓰기
MCP 서버를 내장해 Claude Code, Codex 같은 MCP 클라이언트가 녹취록을 읽고 편집을 제안합니다. 에이전트의 편집은 조용히 적용되지 않습니다. 열려 있는 편집기에 이유와 함께 제안으로 뜨고, 사람이 Enter로 받아들이거나 거절합니다.
claude mcp add trimscript -- uvx trimscript mcp“my-video.mp4에서 데모를 중간에 다시 시작했어. 첫 번째 시도를 지우자고 제안해 줘.”
“발표자 제품명은 Acme야. 녹취록이 잘못 들은 곳을 전부 고쳐 줘.”
제공 도구: transcribe, get_transcript, suggest_removal, correct_text, list_edits, withdraw, enhance_voice, export. 같은 동작을 CLI로도 할 수 있고, 편집기·CLI·MCP 서버가 같은 프로젝트 파일을 읽고 쓰므로 어디서 고치든 열려 있는 편집기가 실시간으로 갱신됩니다.
작동 원리
- 삭제 구간은 단어에서 계산: 지운 부분은 녹취록 항목(단어, 군말, 쉼)의 묶음이고, 잘라 낼 시간은 거기서 유도합니다. 그래서 미리보기와 내보내기가 항상 일치합니다
- 편집점은 단어 사이 한가운데: 쉼과 만나면 약간의 무음을 남깁니다. 인식기가 문장 끝 단어를 뒤 무음까지 늘여 잡는 현상은 음성 에너지가 끝나는 지점으로 단어 경계를 당겨 바로잡습니다
- 군말 인식 누락 막기: 받아쓰기 모델이 군말을 앞 단어에 붙여 버리는 문제는 군말 구간을 일정 폭으로 넓히는 후처리로 풀었습니다. 긴 녹음은 20~28초 조각으로 나누되 가장 긴 무음 한가운데서 자르고, 앞 조각의 마지막 60단어를 다음 조각 프롬프트로 이어 줍니다. 단어 시각은 DTW 정렬로 잡습니다
- 소리와 화면이 어긋나지 않게: 영상은 프레임 경계로 자르고 오디오는 약 1 ms 단위로 잘라, 편집점이 수백 개여도 싱크가 밀리지 않습니다. 편집점이 수백 개일 때 ffmpeg 필터식이 너무 깊어지는 문제는 균형 트리로 바꿔 해결했습니다
실제 강연으로 검증
38C3 공개 강연 3편(CC BY 4.0, 1인 발표)으로 받아쓰기, 군말 정리, 쉼 줄이기, 음성 정리까지 켜고 내보낸 뒤, 더 큰 모델(Whisper large-v3-turbo)로 다시 받아 적어 남은 군말을 셌습니다. M1 Pro 기준입니다.
| 강연 1 | 강연 2 | 강연 3 | |
|---|---|---|---|
| 길이 | 32.9분 | 40.2분 | 36.2분 |
| 줄어든 시간 | 5.2분 | 3.4분 | 6.5분 |
| 내보낸 뒤 남은 군말 | 9개 | 11개 | 31개 |
| 내보낸 길이 vs 계획 | -0.20초 | -0.16초 | -0.10초 |
| 음량 | -14.1 LUFS | -14.3 LUFS | -14.3 LUFS |
| 받아쓰기 시간 | 1.2분 | 1.8분 | 1.7분 |
세 편에서 군말 582개를 지웠고, 내보낸 뒤 51개가 남아 들렸습니다. 측정 방법과 원자료는 spikes/e2e-real에 있습니다.
사용 기술
- Python: FastAPI + uvicorn 로컬 서버, numpy·scipy·noisereduce 음성 처리, pywhispercpp 받아쓰기, MCP Python SDK
- ffmpeg: 별도 프로그램으로 호출해 자르기·합치기·내보내기
- 편집기 UI: React, shadcn/ui, Tailwind CSS
- 테스트·CI: 테스트 41개. macOS·Linux·Windows에서 받아쓰기부터 내보내기까지 매 푸시 실행
범위
멀티트랙 타임라인, 화면 녹화, 음성 복제, 협업 기능은 없습니다. 그게 필요하면 FCPXML로 내보내 전문 편집기에서 이어 갑니다.